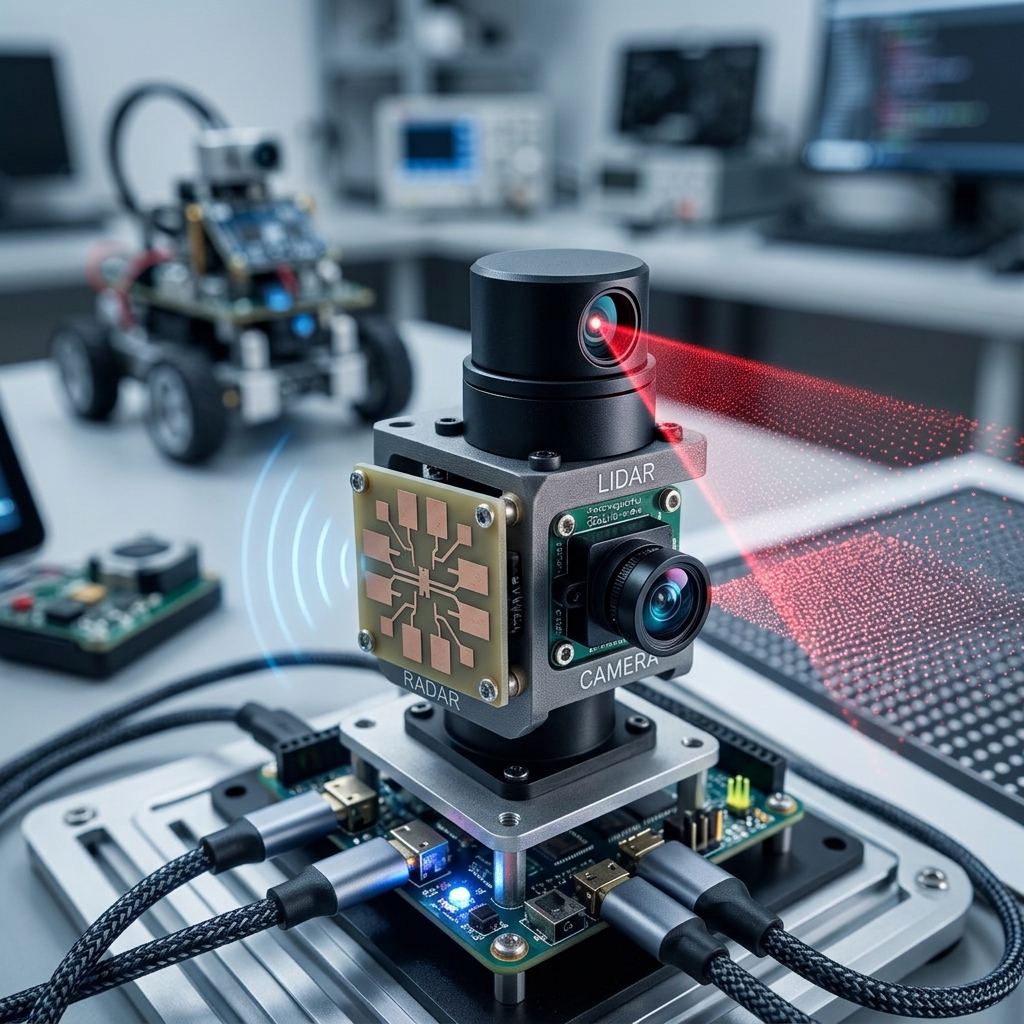
Immagina di dover descrivere una stanza a qualcuno che non può vederla. Potresti elencare gli oggetti e le loro posizioni, disegnare una mappa, o semplicemente scattare una foto. Ogni metodo ha i suoi limiti e i suoi punti di forza. È esattamente così che funzionano i tre sensori protagonisti della percezione moderna — Lidar, Radar e Telecamere — ognuno con un “linguaggio” diverso per raccontare al computer cosa c’è là fuori. Ma cosa li distingue davvero? E perché, nonostante decenni di ricerca, nessuno di loro è ancora riuscito a “vincere” da solo?
Il Punto di Partenza: Attivi vs. Passivi
Prima di addentrarci nelle differenze tecniche, è fondamentale capire una distinzione ontologica. Lidar e Radar sono sensori “attivi”: emettono un segnale e misurano ciò che torna indietro. Le telecamere sono “passive”: si limitano a catturare la luce che esiste già nell’ambiente. Questa differenza apparentemente banale ha conseguenze profonde su tutto il resto.
Lidar: Il Geometra della Luce
Lidar (Light Detection and Ranging) funziona come un pipistrello con un laser. Emette impulsi di luce — tipicamente nel vicino infrarosso, tra 600 e 1000 nanometri — e misura il tempo impiegato dal raggio per colpire un oggetto e tornare indietro. Il principio è noto come Time-of-Flight (ToF).
Il risultato è una nuvola di punti: una rappresentazione tridimensionale dell’ambiente con una precisione che può raggiungere i ±2-5 centimetri. Immagina di poter “toccare” ogni oggetto nella scena a distanza, registrando la sua posizione esatta nello spazio. Questa è la forza del Lidar: precisione geometrica senza pari.
Tuttavia, il Lidar ha un tallone d’Achille: il maltempo. Pioggia, neve, nebbia o polvere diffondono il laser, degradando drasticamente la qualità dei dati. Inoltre, il costo — sebbene in calo grazie ai sistemi a stato solido — rimane significativo, e la sua dimensione fisica ha spinto alcuni produttori (su tutti Tesla) a rifiutarlo in favore di approcci puramente visivi.
Radar: Il Veterano delle Onde Radio
Radar (Radio Detection and Ranging) è il più anziano dei tre. Nato per scopi militari durante la Battaglia d’Inghilterra, utilizza onde radio nella banda delle microonde — tipicamente 76-81 GHz nel settore automobilistico. Funziona come il Lidar: emette un segnale, aspetta l’eco, calcola distanza e direzione.
La differenza cruciale? Le onde radio attraversano pioggia, nebbia e neve senza quasi risentirne. Il Radar è il sensore “all-weather” per eccellenza. Inoltre, grazie all’effetto Doppler, misura direttamente la velocità degli oggetti con precisione straordinaria — spesso ±0.1 m/s. Quando vuoi sapere non solo dove è un’auto ma quanto velocemente si muove verso di te, il Radar è insostituibile.
Il prezzo da pagare è la risoluzione spaziale limitata. Il Radar “vede” oggetti ma non dettagli: un pedone può apparire come un punto indistinto, e i dettagli fini — come un semaforo o un segnale stradale — sfuggono alla sua portata.
Telecamere: L’Occhio Semantico
Le telecamere sono l’unico sensore passivo del trio. Catturano la luce riflessa dagli oggetti e la convertono in segnali elettrici attraverso sensori a semiconduttore — CCD o CMOS. Il loro vantaggio è semantico: una telecamera non dice solo “c’è un oggetto a 15 metri”, ma “c’è un pedone che indossa una giacca gialla e sta guardando verso destra”.
Questa ricchezza di informazione visiva è insostituibile. Solo una telecamera può leggere un segnale stradale, riconoscere un gesto, o distinguere una bicicletta da un motorino. Ed è economica: la tecnologia del silicio segue la legge di Moore, con risoluzioni che raddoppiano ogni 18 mesi circa.
Ma il suo limite è altrettanto netto: la telecamera non ha profondità. Una singola immagine bidimensionale non dice nulla sulla distanza. Per stimarla servono algoritmi complessi (stereo vision) o l’aiuto di altri sensori. E la sua dipendenza dalla luce la rende vulnerabile: di notte, con abbagliamento solare, o in caso di oscuramento, la telecamera diventa cieca.
Il Confronto Diretto: Chi Vince su Cosa?
Una recente analisi comparativa ha quantificato le performance di ciascun sensore in scenari reali di guida autonoma. I risultati sono illuminanti.
In termini di precisione di rilevamento (mAP, mean Average Precision), la telecamera da sola raggiunge 0.62, il Lidar 0.65, il Radar solo 0.48. Ma quando si combinano Camera + Lidar, si sale a 0.70, e la fusione completa dei tre sensori tocca 0.74.
Ancora più interessante è l’analisi dell’errore di traiettoria (ADE, Average Displacement Error): la fusione totale riduce l’errore a 0.91 metri, contro 1.10 della telecamera sola e 1.30 del Radar solo. In altre parole, nessun sensore è sufficiente da solo, ma insieme si correggono a vicenda.
C’è però un trade-off: la latenza. La fusione completa richiede 55 millisecondi per frame, contro i 33 ms del Radar da solo. In un’auto che viaggia a 130 km/h, 22 millisecondi in più significano circa 80 centimetri di strada percorsa senza aggiornamento. Un dettaglio non banale.
Perché la Fusione è l’Unica Risposta Sensata
La lezione che emerge dalla ricerca è chiara: Lidar, Radar e Telecamere non sono concorrenti, sono complementari.
Il Lidar eccelle nella geometria 3D ma soffre il maltempo. Il Radar è robusto e preciso sulla velocità ma cieco ai dettagli. La telecamera è ricca di significato ma priva di profondità e vulnerabile alla luce.
La fusione multisensoriale — resa possibile da architetture come il Bird’s Eye View (BEV) fusion e modelli Transformer spaziotemporali — combina il meglio di ciascuno. Il risultato non è semplicemente “la somma delle parti”, ma un sistema percettivo olistico in cui ogni sensore compensa i difetti degli altri.
La prossima volta che vedi un’auto a guida autonoma — o semplicemente un’auto moderna con assistenza alla guida — ricorda: dietro il suo “sguardo” ci sono tre occhi diversi, ciascuno con una storia, un linguaggio e un punto cieco. È la loro conversazione silenziosa che tiene le ruote sulla strada.